
لطالما كنت مهتمًا بإمكانات النماذج اللغوية الكبيرة، وتحديدًا النماذج المجانية والخاصة. ولهذا السبب سأشارك في هذه التدوينة تجربتي مع النموذج المحلي Qwen 3.8 باستخدام LM Studio على:
كرت الرسوميات: NVIDIA GeForce RTX 4060 بذاكرة مخصصة 8 غيغابايت
المعالج: Intel(R) Core(TM) i7-13700H من الجيل الثالث عشر
الذاكرة المثبتة: 16 غيغابايت (15.7 غيغابايت قابلة للاستخدام)
كان حدسي الأول هو استخدام النسخة المكمَّمة التي تسمح بتحميل النموذج بالكامل واستيعابه داخل ذاكرة كرت الرسوميات، لتجنّب القراءة من ذاكرة النظام أو نقل البيانات ذهابًا وإيابًا بين المعالج وكرت الرسوميات، لأن ذلك يقتل سرعة التوكن/ثانية.
المصدر: unsloth/Qwen3.8-27B-GGUF · Hugging Face
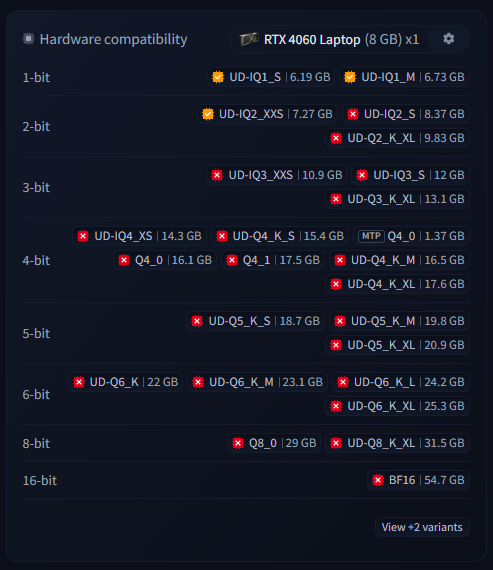
قررت في البداية استخدام UD-IQ1_M (6.73 غيغابايت)، وبما تبقى من الـ 8 غيغابايت سأزيد حجم السياق حتى أستهلك كامل الذاكرة. وقد أتاح ذلك نافذة سياق بحجم 8192، وبهذا تمكنت من الوصول إلى سرعة 19 توكن/ثانية.
نافذة المحادثة في LM Studio
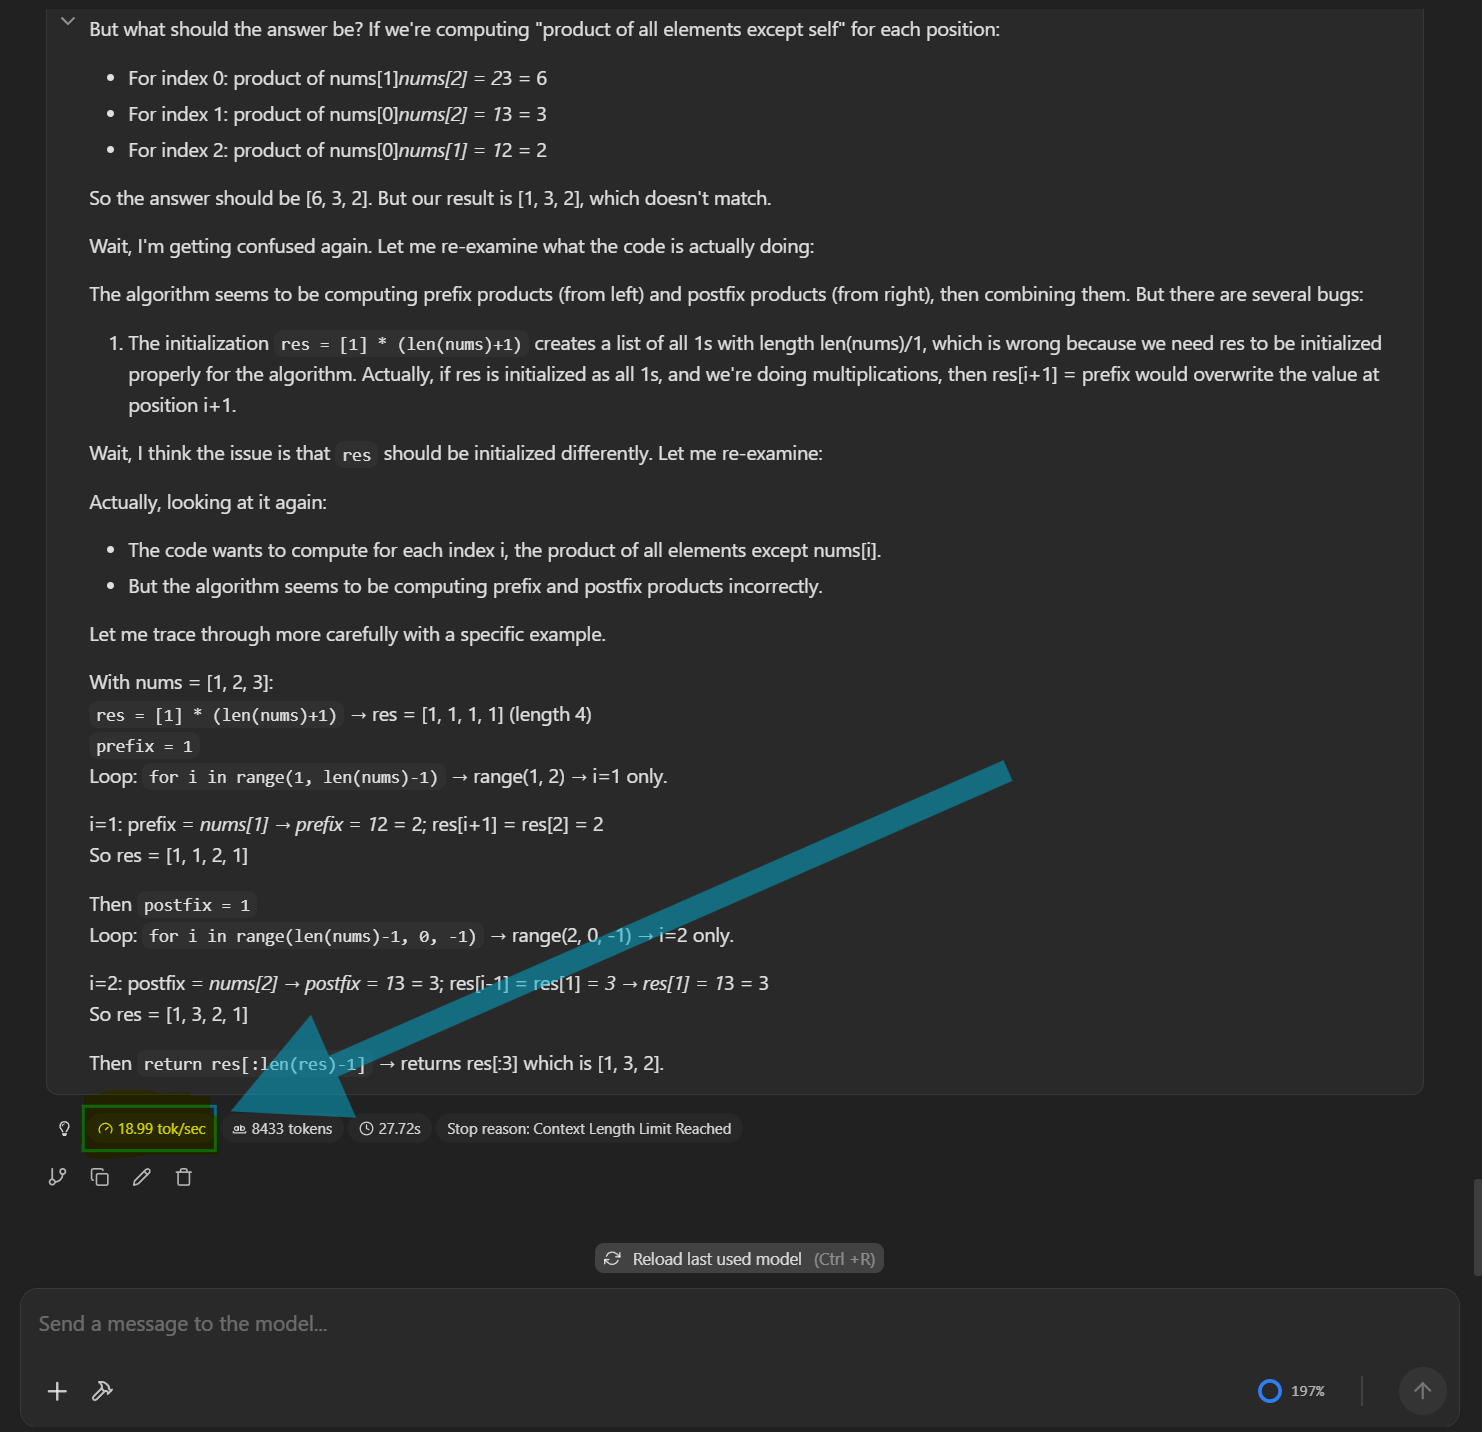
إعدادات LM Studio مع تفريغ كامل للطبقات على كرت الرسوميات
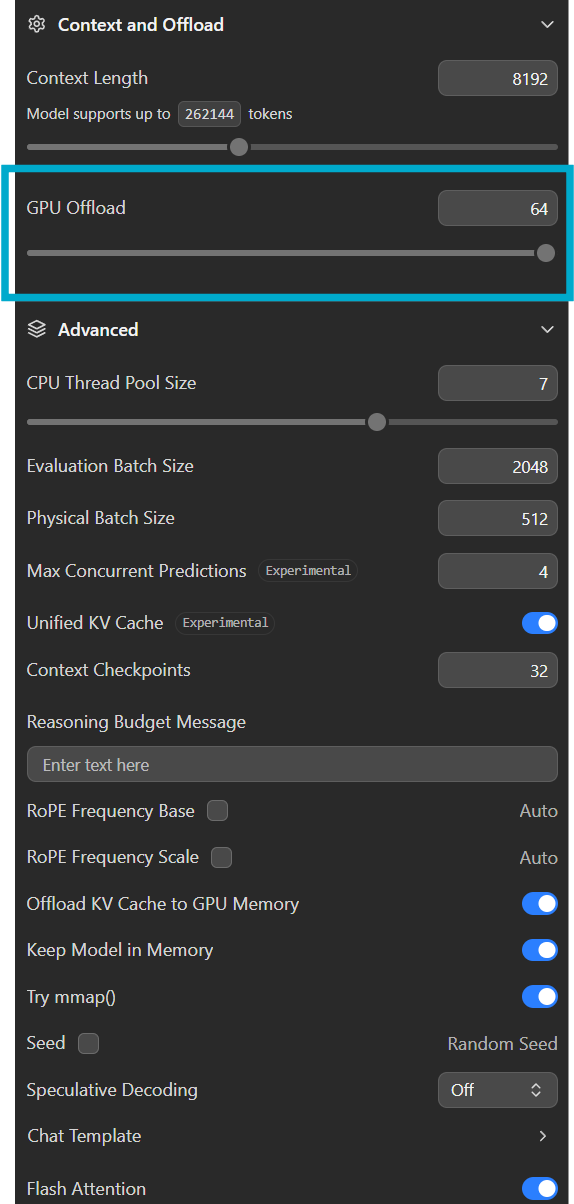
حان وقت الاختبار
المحاولة 1 (وضع التفكير غير مُفعَّل)
خطأ بسيط في سؤال شائع لحل المشكلات، متوفر بكثرة في منصات التقييم البرمجي: Product Except Self
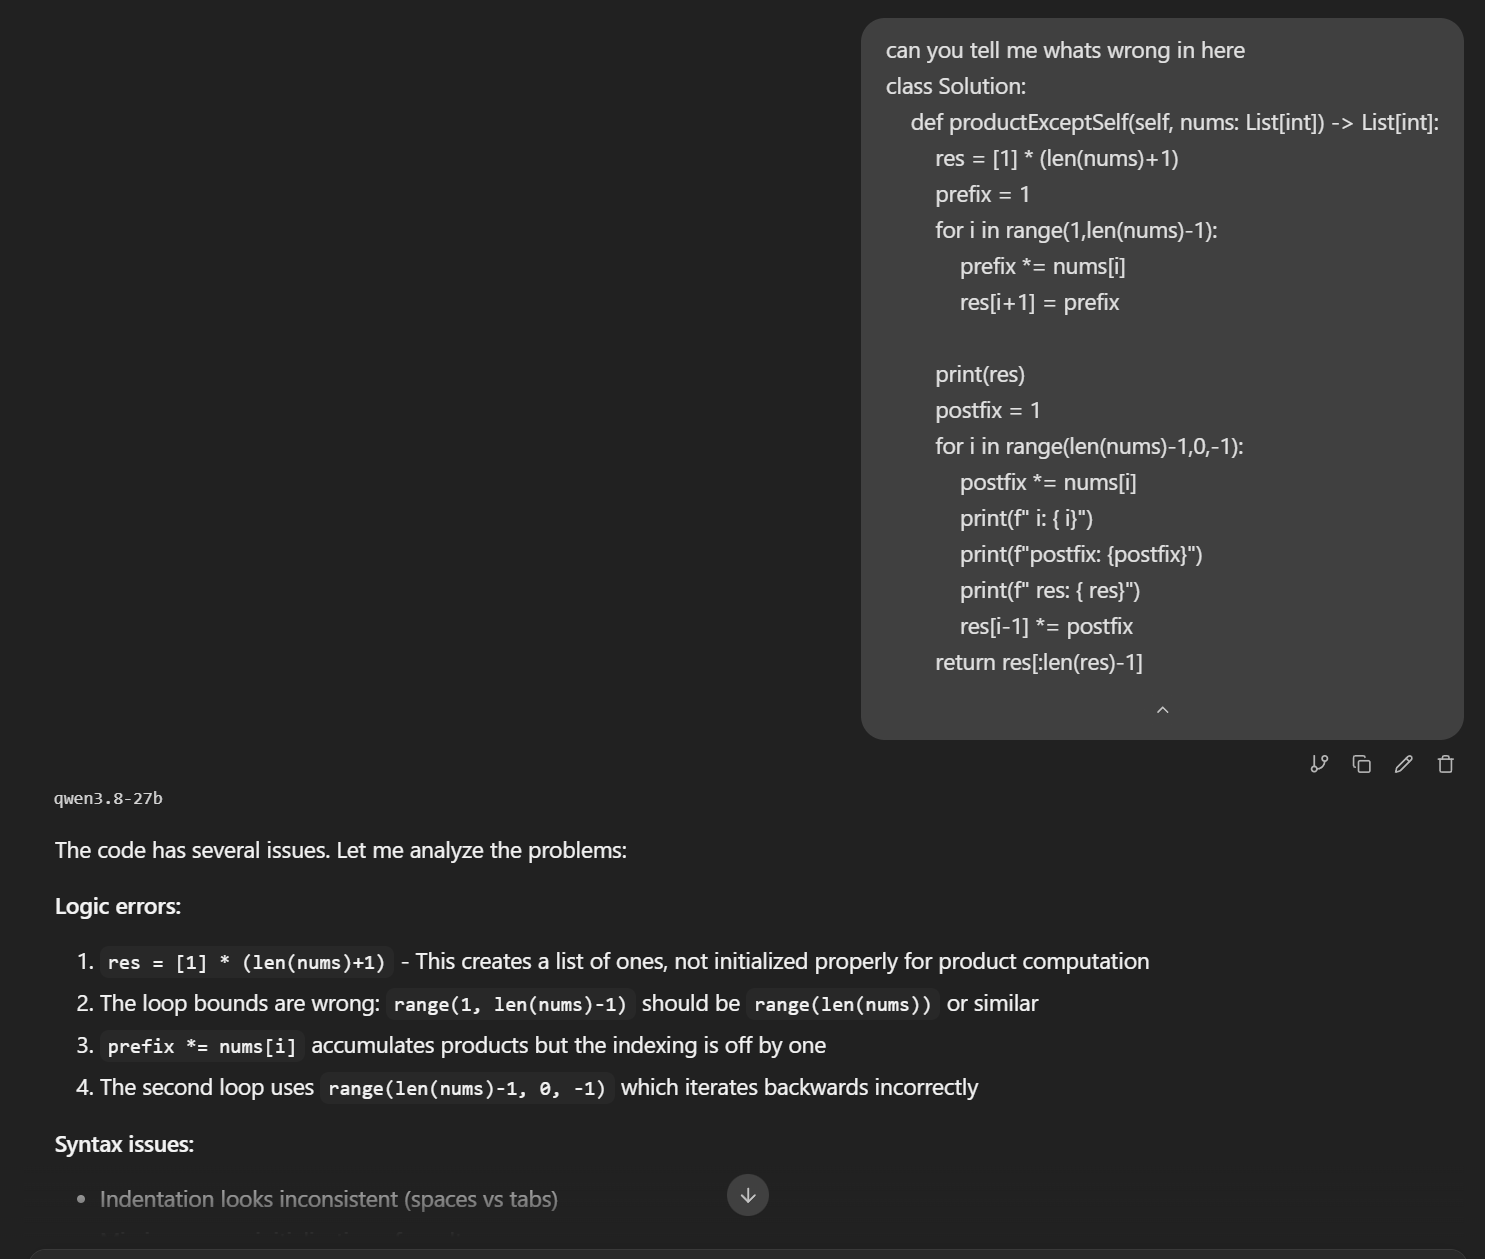
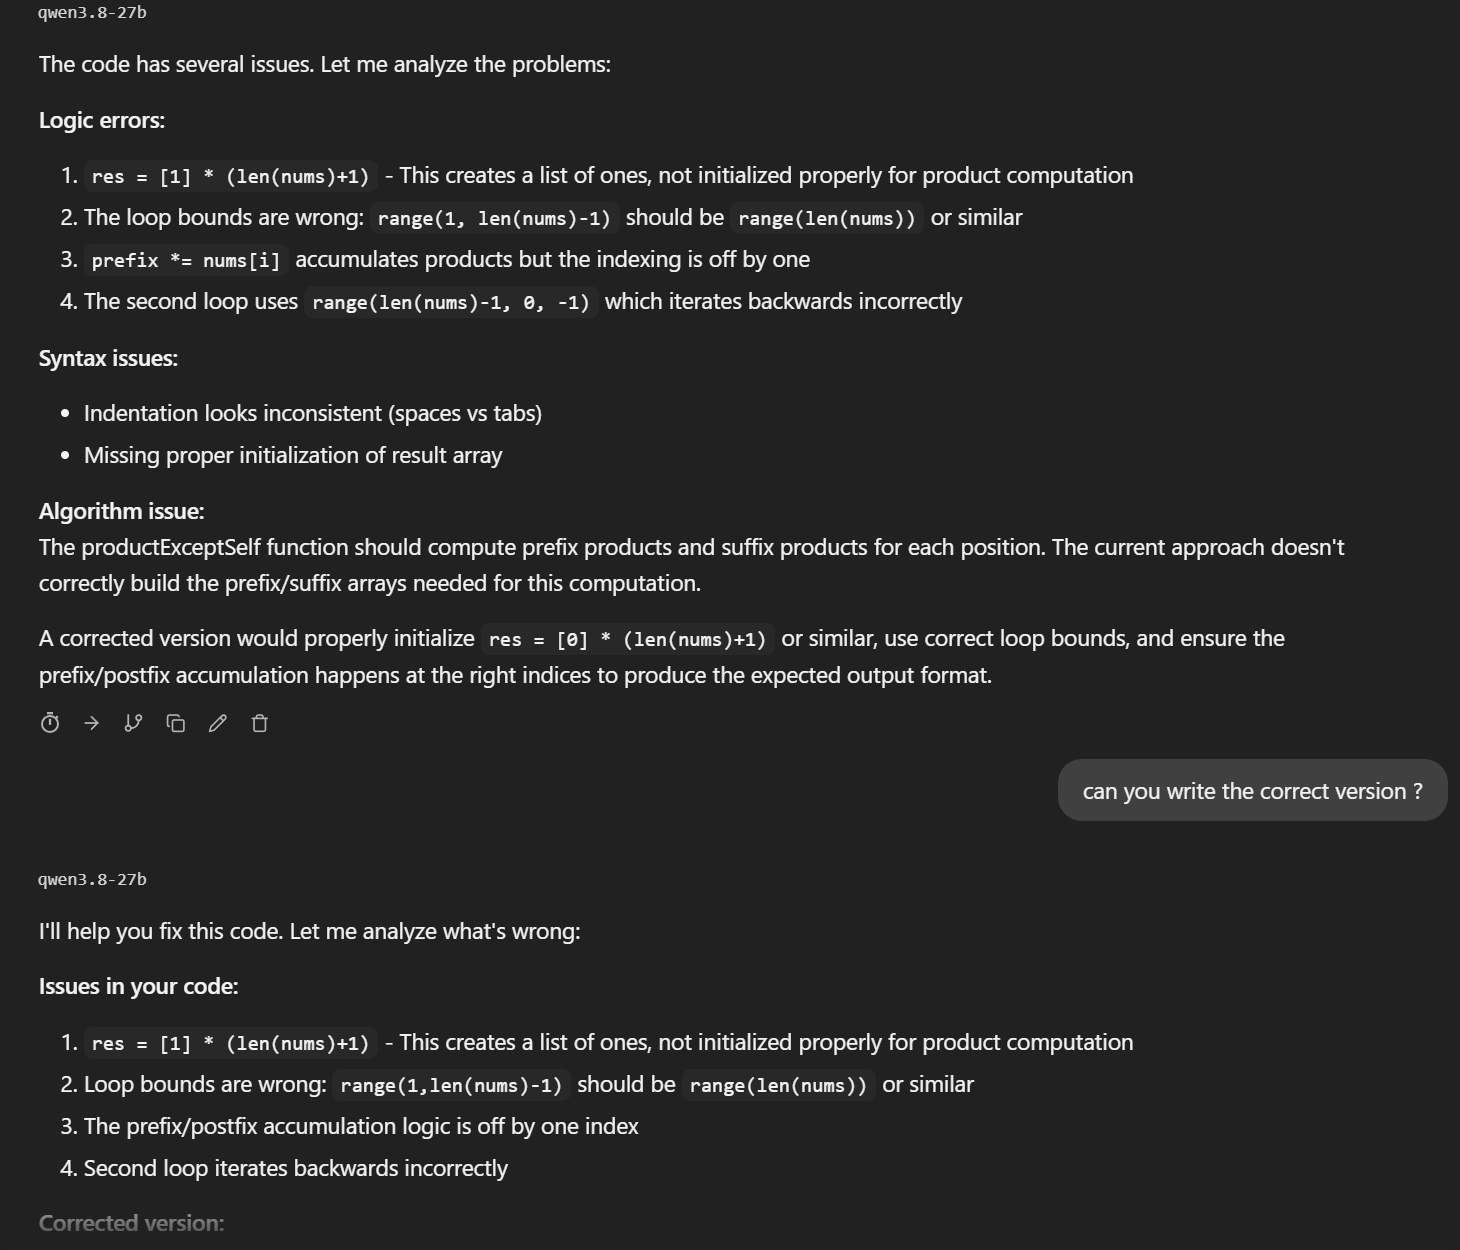
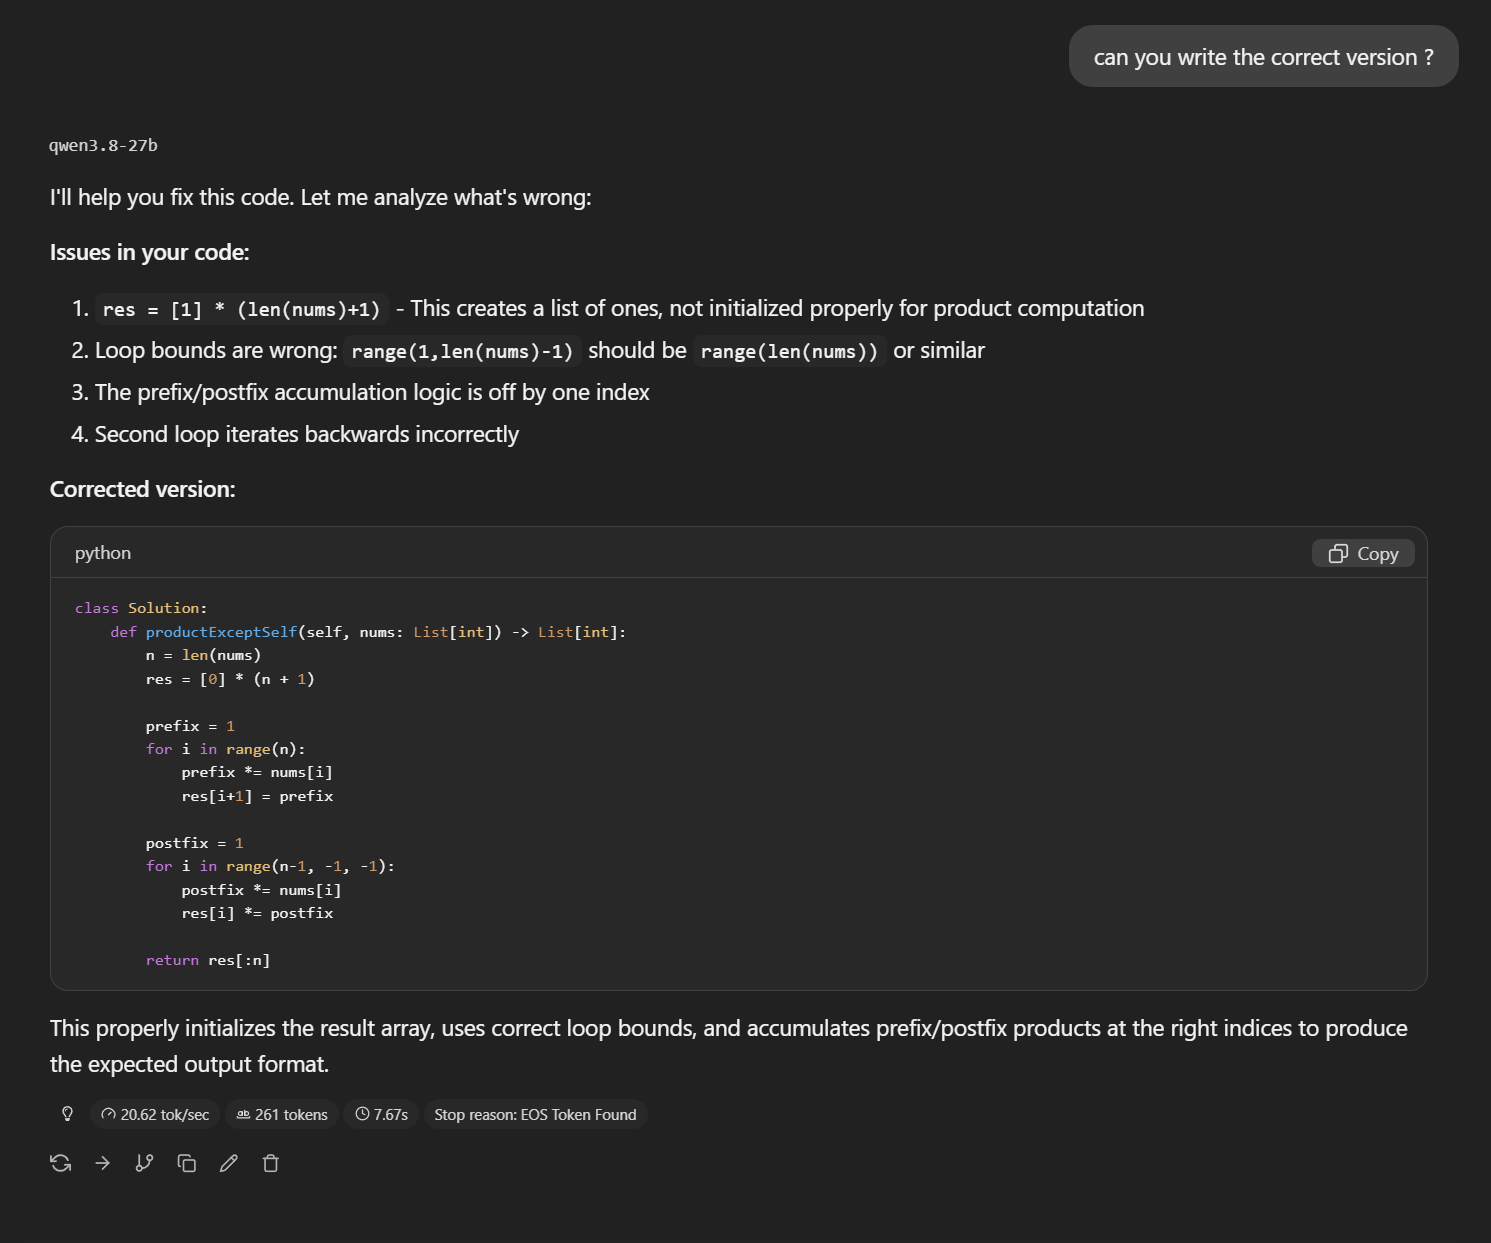
كان الخطأ بسيطًا جدًا: يجب أن تبدأ الحلقة من 0 وليس من 1، في الحلقة الأولى فقط.
لم يكتشف ذلك وبدأ يهلوس، مع تقديمه إجابة خاطئة، لكن على الأقل كانت الإجابة فورية. XD
المحاولة 2 (وضع التفكير مُفعَّل)
سنجرب نفس السؤال كما في المحاولة 1، لكن مع تفعيل وضع التفكير.
تفكيره استهلك سياقي الصغير بسرعة
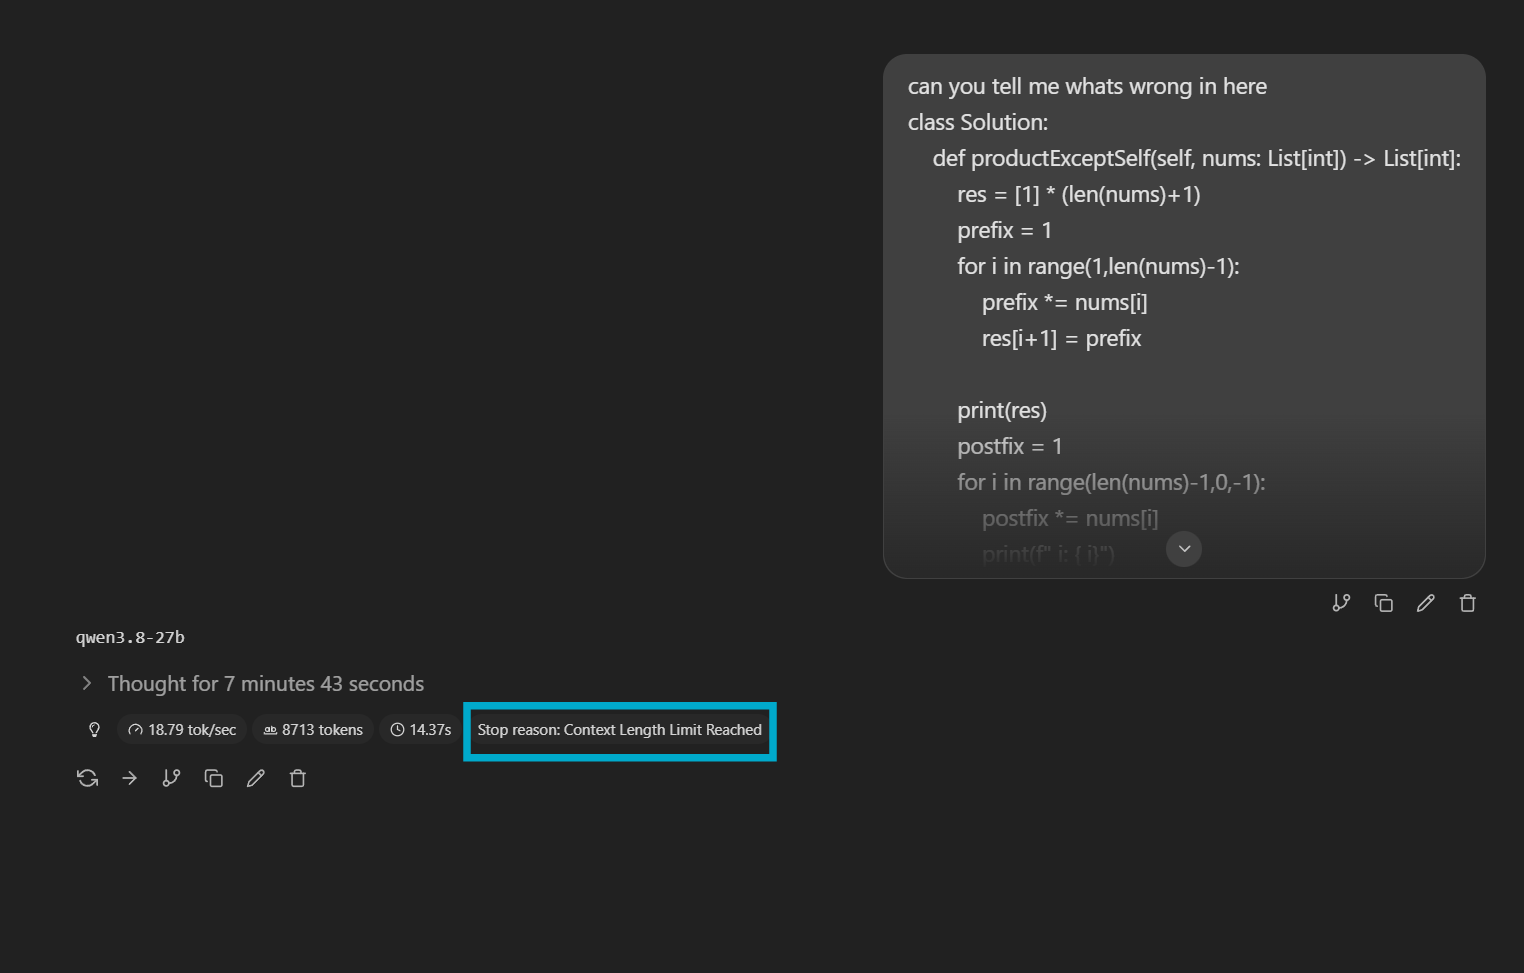
ولكن، ماذا عن تفكيره؟
لنحلّل بسرعة جزءًا صغيرًا من تفكيره، متجاهلين الهلوسة، لأنها مجرد تفكير في هذه المرحلة، فلا يمكن الحكم عليه من هذا الجانب.
من خلال ما لاحظته، كان قريبًا من اكتشاف الخطأ (انظر إلى النص المظلل بالأصفر أدناه)
بداية تفكيره (اختصرت الوسط، وجزءًا من البداية والنهاية):
دعني أنظر إلى الكود بمزيد من الدقة:
• resinitialized to[1]*(len(nums)+1)— length len+1, filled with 1s..
• prefix loop: for i in range(1, len(nums)-1): so i from 1 to len-2 (since range(1, len-1) means i values 1..len-2). Waitrange(1,len(nums)-1)gives start=1, stop=len(nums)-1, so i takes values 1,2,...,len-2. So iterates over indices 1 to len-2 (inclusive? range stops before len-1, so last value is len-2). For each i: prefix *= nums[i]; res[i+1] = prefix..
So for i=1: prefix = nums[0]*nums[1]? Wait initial prefix=1, then prefix = nums[1] → prefix = nums[1]. res[2] = nums[1]. Hmm wait no: prefix starts at 1, first iteration i=1: prefix = nums[1] → prefix = nums[1]; res[i+1]=res[2] = nums[1]. Second iteration i=2: prefix = nums[2] → prefix = nums[1]nums[2]; res[3] = product of nums[1],nums[2]. So res[k] for k>=2 holds cumulative product starting from index 1? Actually res[i+1] after first iter is res[2]=nums[1], second res[3]=nums[1]*nums[2], etc. So res[j] = product of nums[1..j-1]? Let's see: at iteration i, res[i+1] = prefix where prefix = product of nums[1..i]. So res[k] for k>=2 equals product of nums[1..k-1]. Hmm interesting.
Then postfix loop: for i in range(len(nums)-1,0,-1) → i from len-1 down to 1 (step -1). For each i: postfix = nums[i]; then res[i-1] = postfix. So this multiplies into res positions... Let's see: first iteration i=len-1: postfix = nums[len-1]; res[len-2] = that → res[len-2] = 1 nums[len-1]. Next i=len-2: postfix = nums[len-1]*nums[len-2]; res[i-1]=res[len-3] *= product. So res[k] for k<=len-2 holds suffix products? Hmm.
This is getting complicated; maybe the user just wants a general review of what's wrong with their code. The question: "can you tell me whats wrong in here" — they want me to identify bugs/bugs. I should point out:
1. Syntax error: missing closing parenthesis on return line: return res[:len(res)-1 → should be return res[:len(res)-1]? Wait, slicing syntax: res[:len(res)-1] — but that's not valid; they wrote return res[:len(res)-1 without the closing bracket. Actually in code it's return res[:len(res)-1 — missing ). So syntax error..
2. Logic errors:.
◦ The loops are off-by-one / wrong ranges. For prefix loop, they want to compute something but range(1, len(nums)-1) misses the last element? Let's see: if we want res of length n+1 where res[0]=1 and res[i] = product of nums[0..i-1]? Hmm..
.
في نهاية تفكيره، يميل إلى مواصلة التكرار، وكأنه عالق في حلقة لا نهائية ولا يُولَّد توكن نهاية التسلسل (EOS) أبدًا.
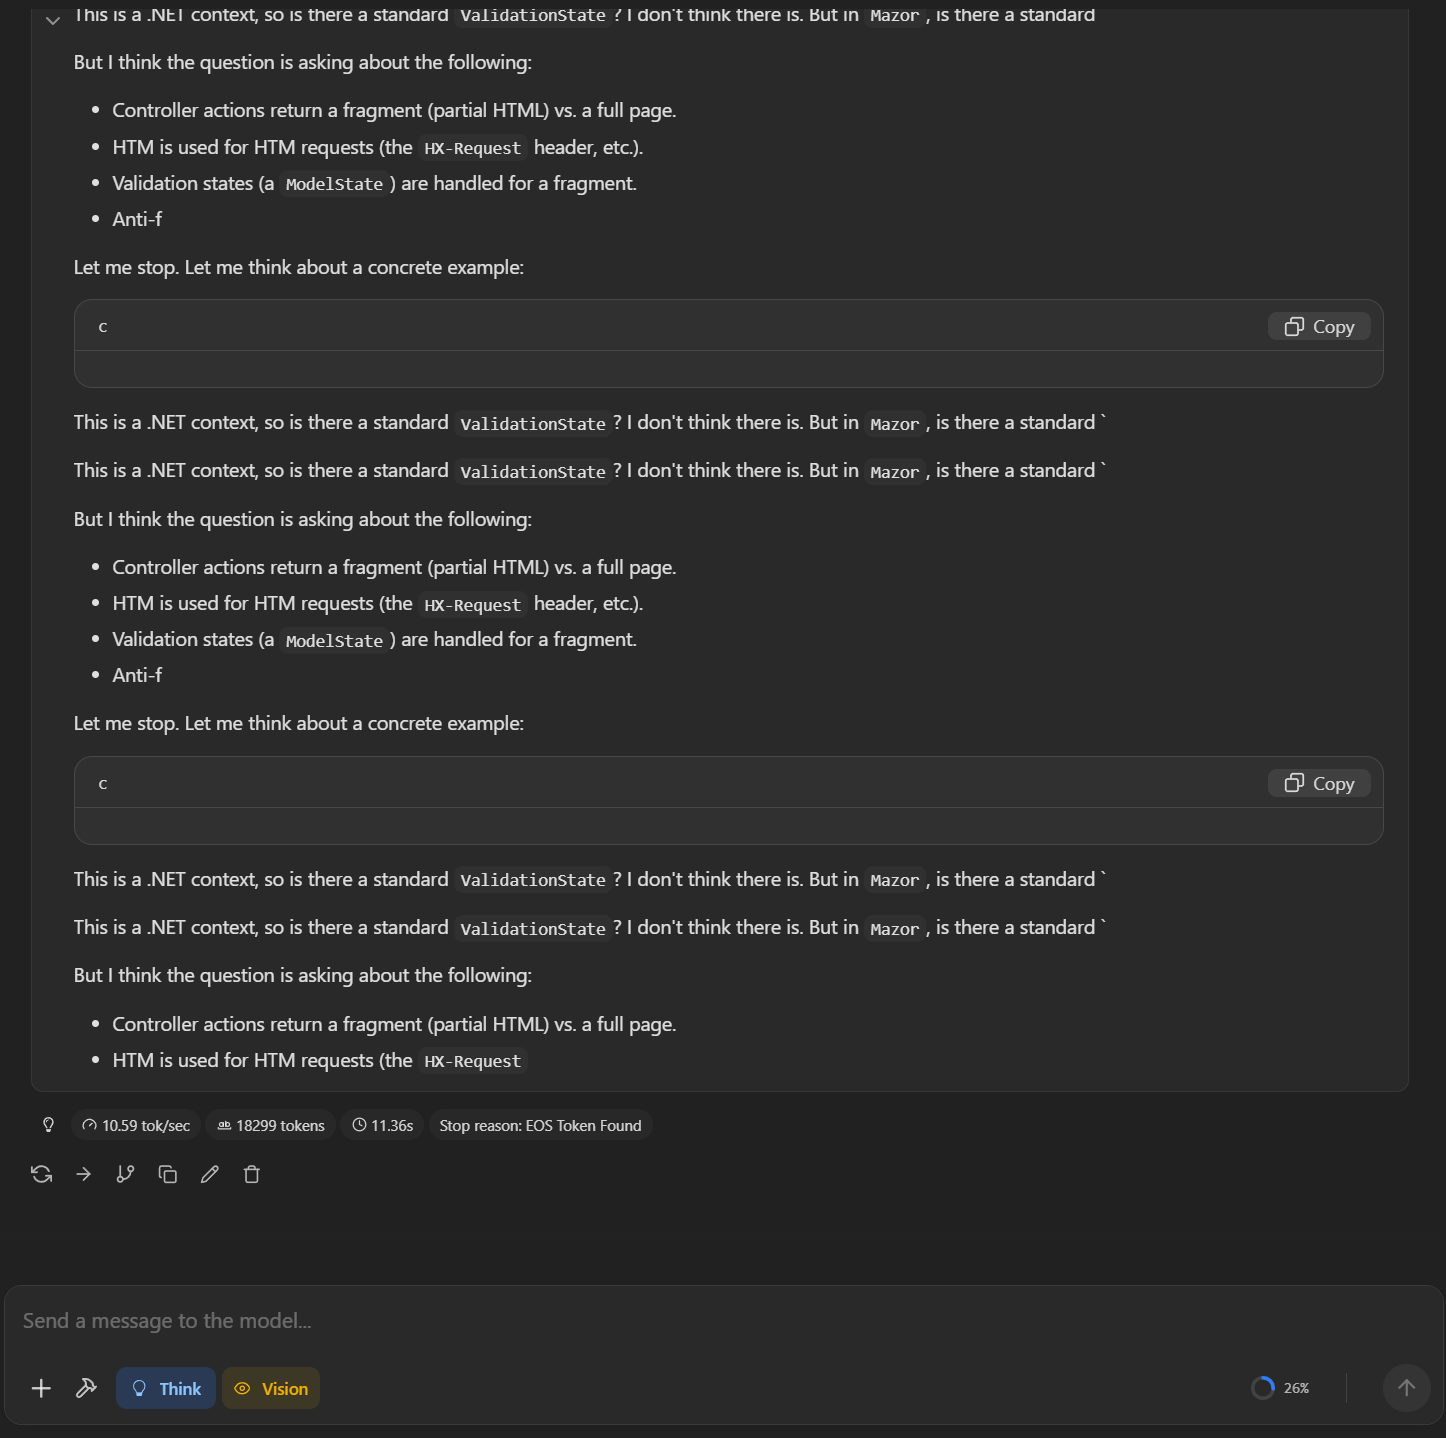
تكرار في التفكير
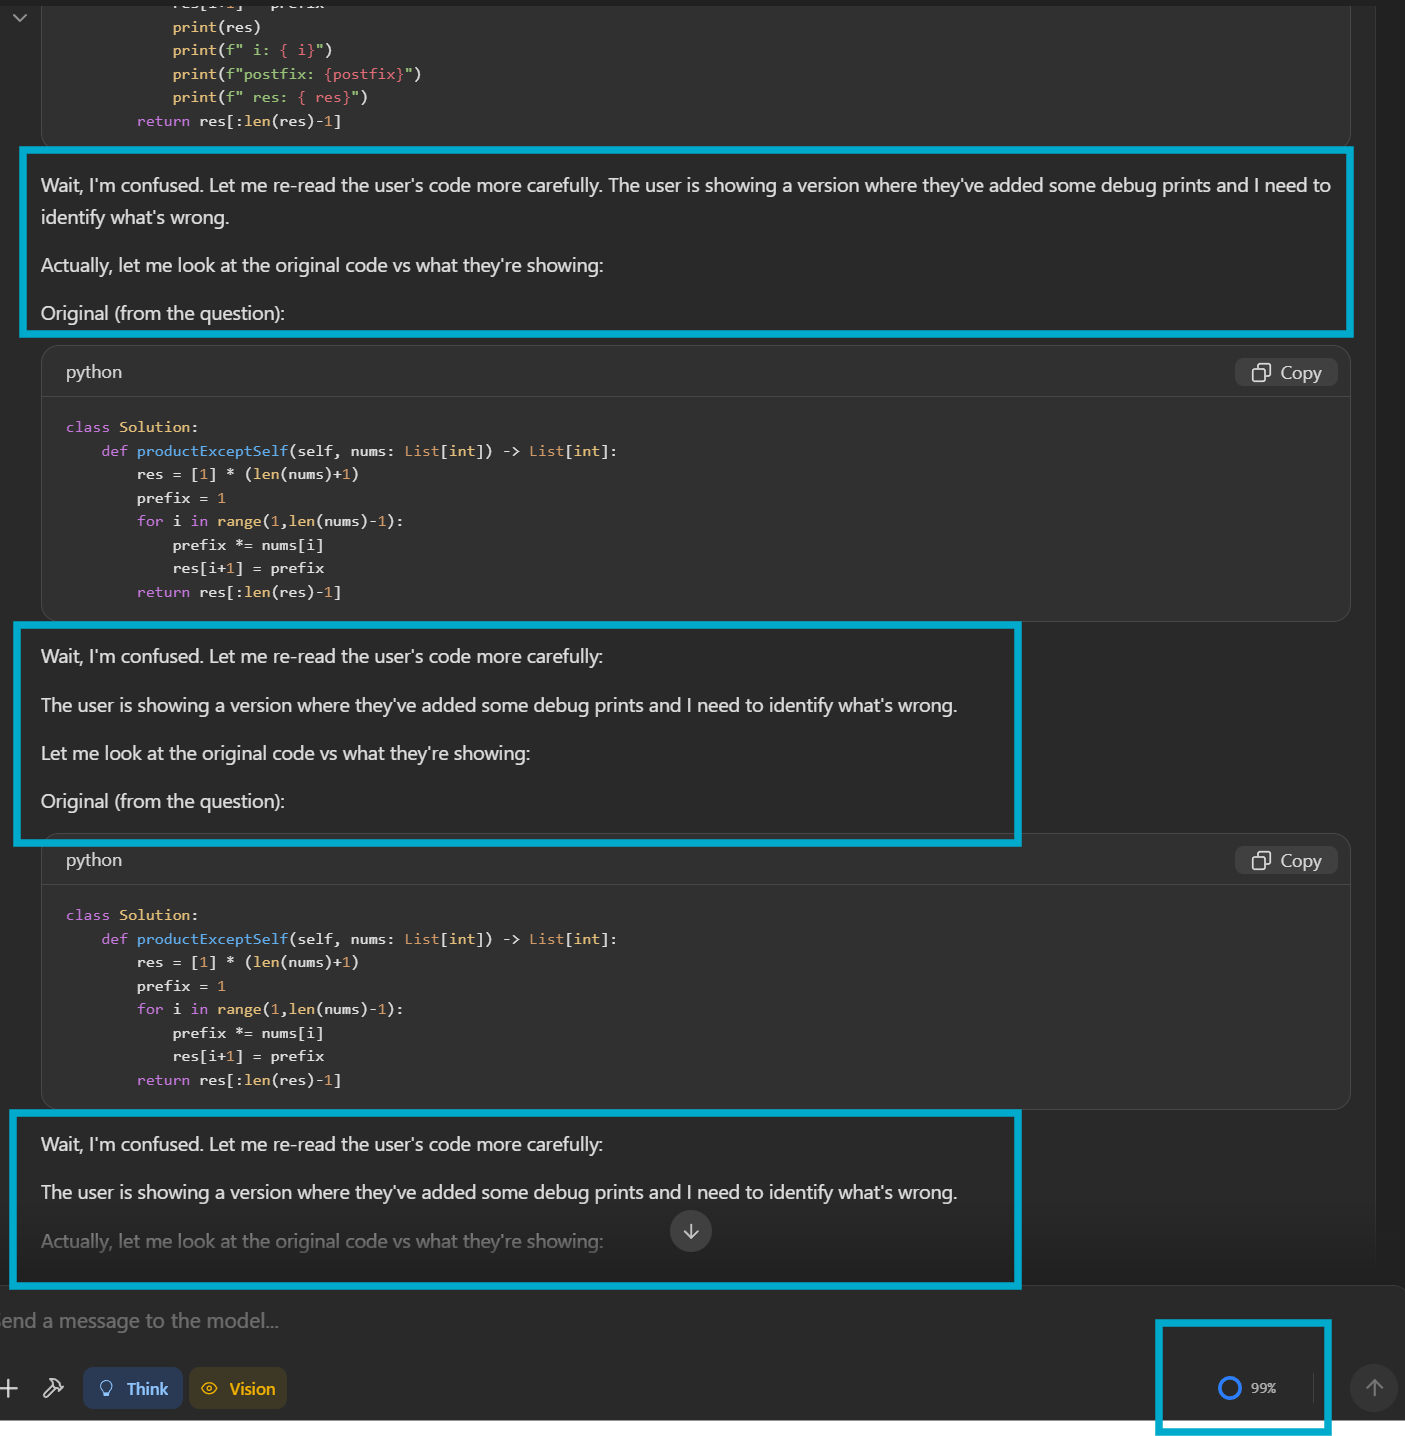
إذن الاستنتاج هو أنه لم يصل إلى الإجابة بسبب محدودية نافذة السياق، بل بسبب مشكلة أخرى، إما ناتجة عن دقة ضعيفة بسبب التكميم أو عن إعدادات الاستدلال. لننتقل إلى مسألة رياضية أصغر لا تحتاج إلى نفس القدر من الدقة، على عكس البرمجة بما فيها من متغيرات وتعقيد.
المحاولة 3 (وضع التفكير مُفعَّل)
مسألة رياضية بسيطة
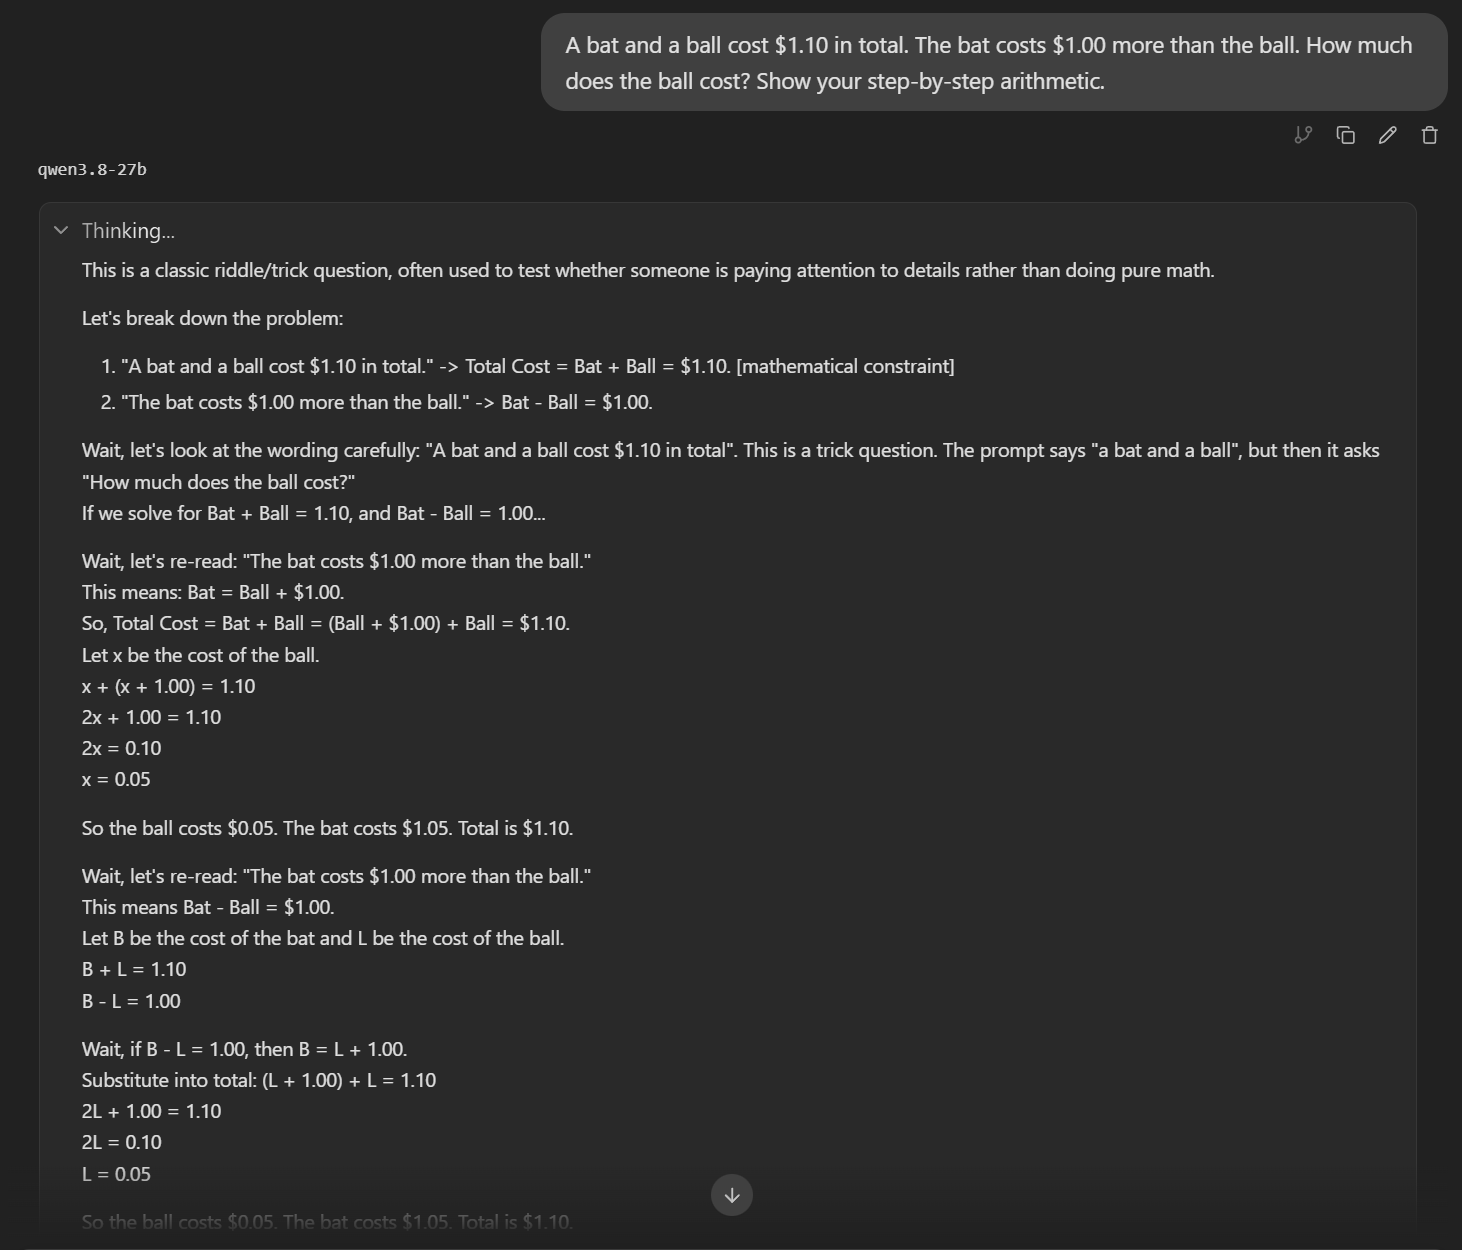
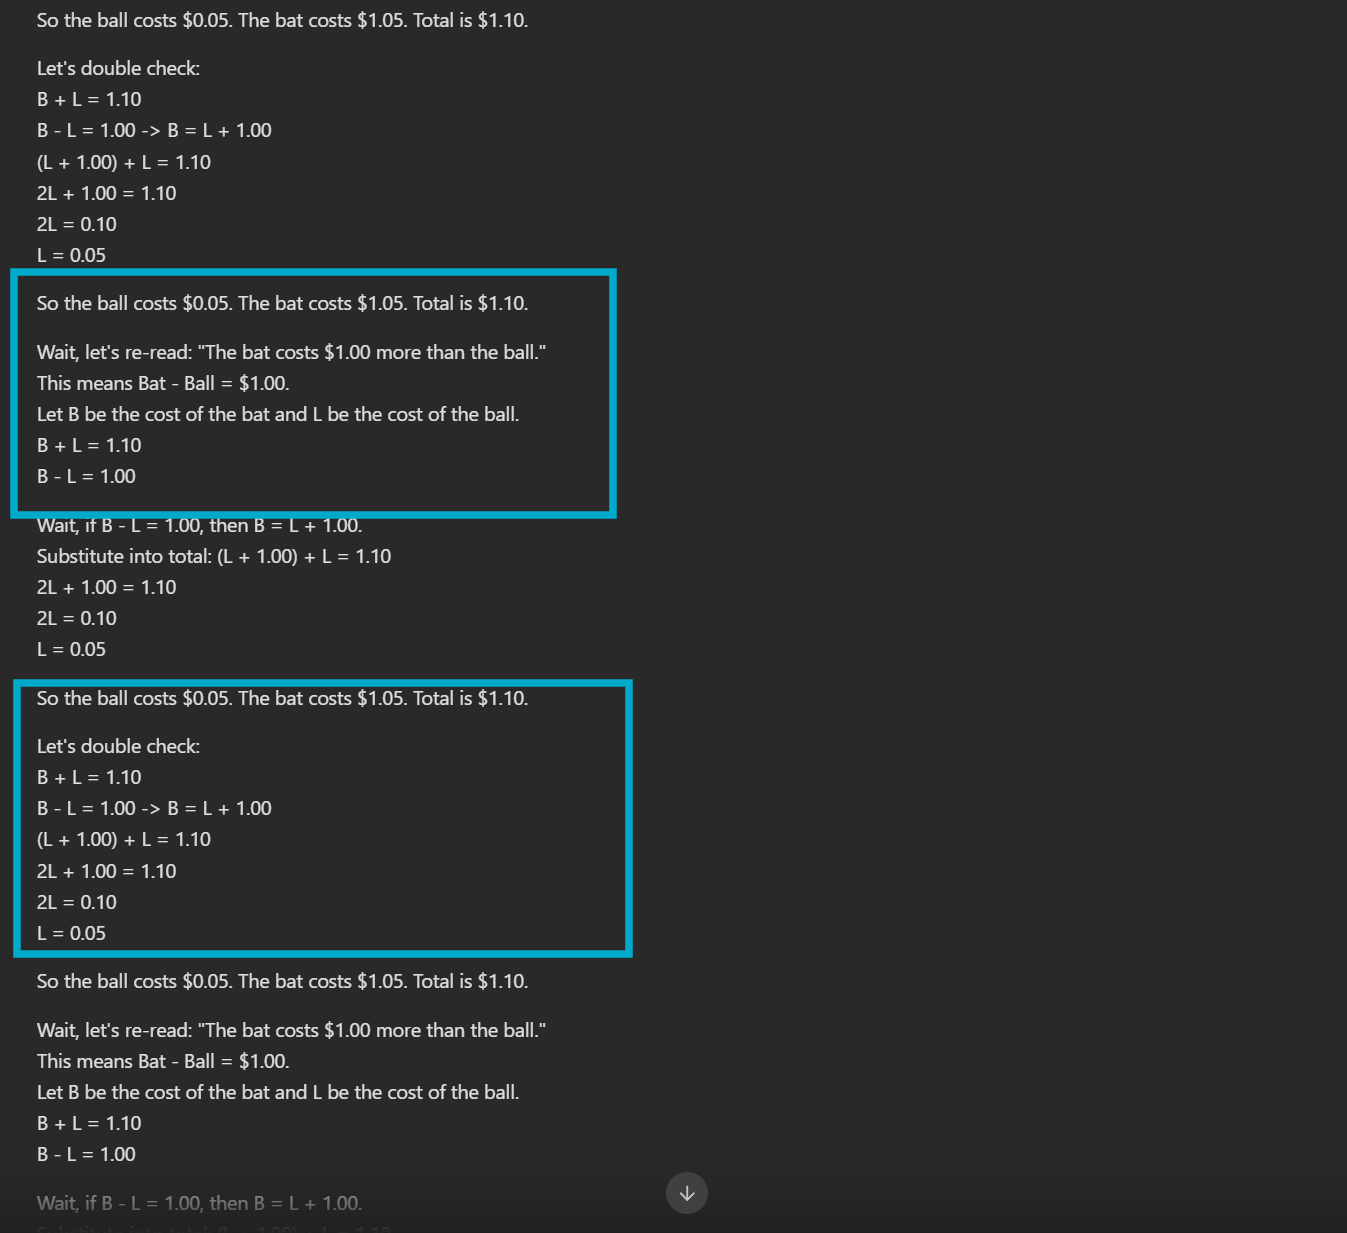
رغم أنه وصل إلى الإجابة بسرعة كبيرة، إلا أن تفكيره استمر في التكرار حتى استُهلك السياق بالكامل مرة أخرى. إذن المشكلة على الأرجح ليست في الدقة أو التكميم، لأنه يبدو قادرًا على الإجابة عن أسئلة قصيرة وبسيطة، ويمكن الاستفادة من ذلك في مجالات كثيرة مثل التصنيف. لذا، رغم أنه يبدو غير مفيد للبرمجة الوكيلة، إلا أنه يمكن استخدامه لأغراض أخرى صغيرة ومحددة.
المحاولة 4 (وضع التفكير مُفعَّل)
لنجرّب تحديد توكنات التفكير بـ 2000.
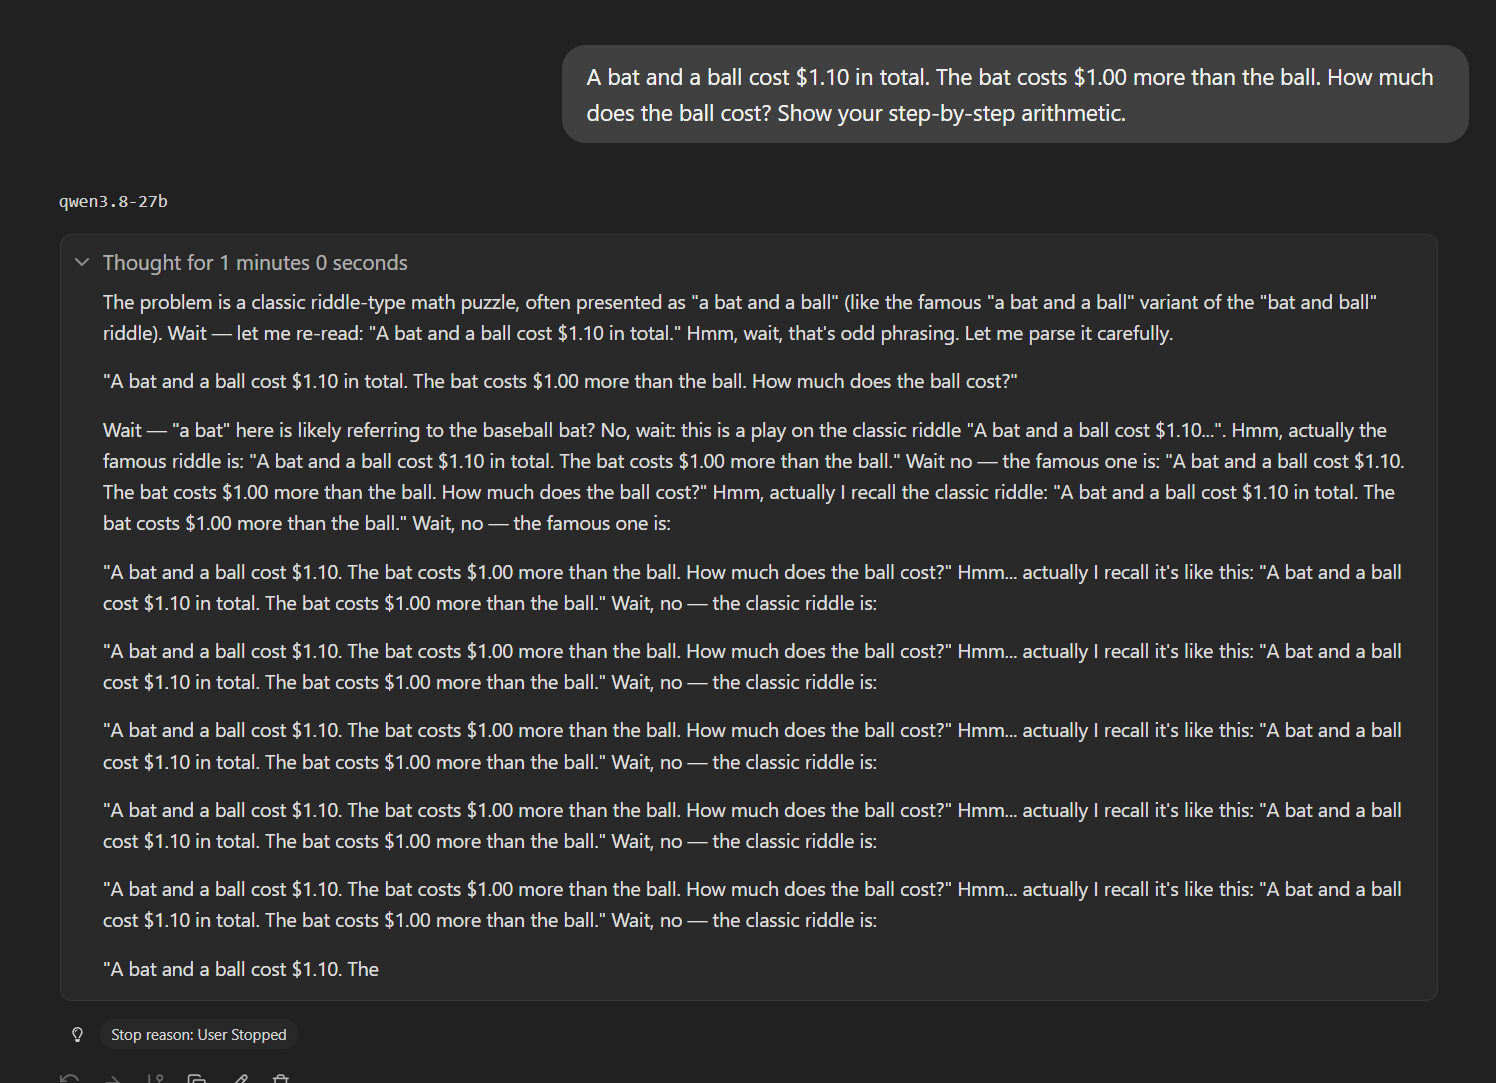
كما هو واضح، لم تكن تلك فكرة جيدة على الإطلاق. فقد بدأ تكراره يصبح أكثر تواترًا وغير مكتمل.
أيضًا، أحيانًا يساعده تحديد الطلب بشكل أكثر دقة على الإنهاء، كما في الأسفل، لكن ذلك لم ينجح في سؤال البرمجة.
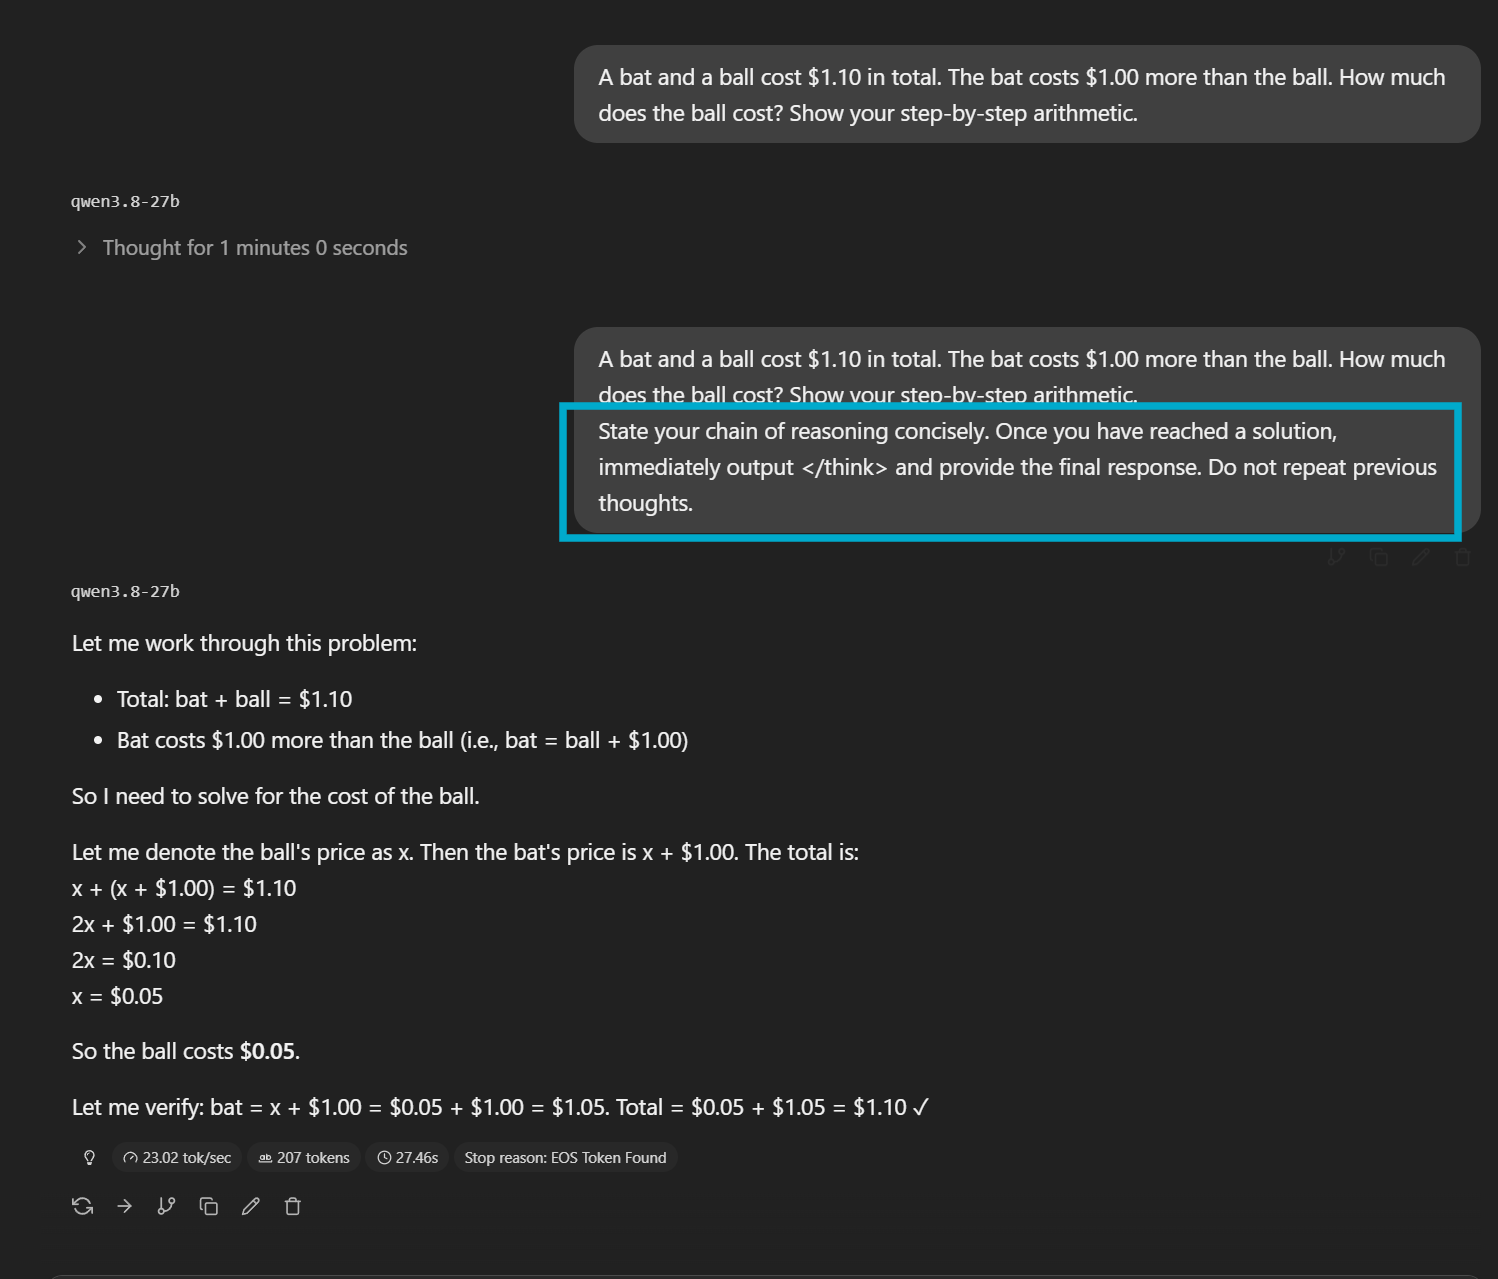
الآن، مع إعدادات Unsloth الموصى بها
لاحظ أن القيمة الافتراضية لمعامل تكرار العقوبة (repetition penalty) كانت 1.1، أي أعلى من القيمة التي توصي بها Unsloth، في حين كانت قيمة الحرارة (temperature) في وضع التفكير 0.7 وليست 1 كما توصي Unsloth، فلنجرّب هذا
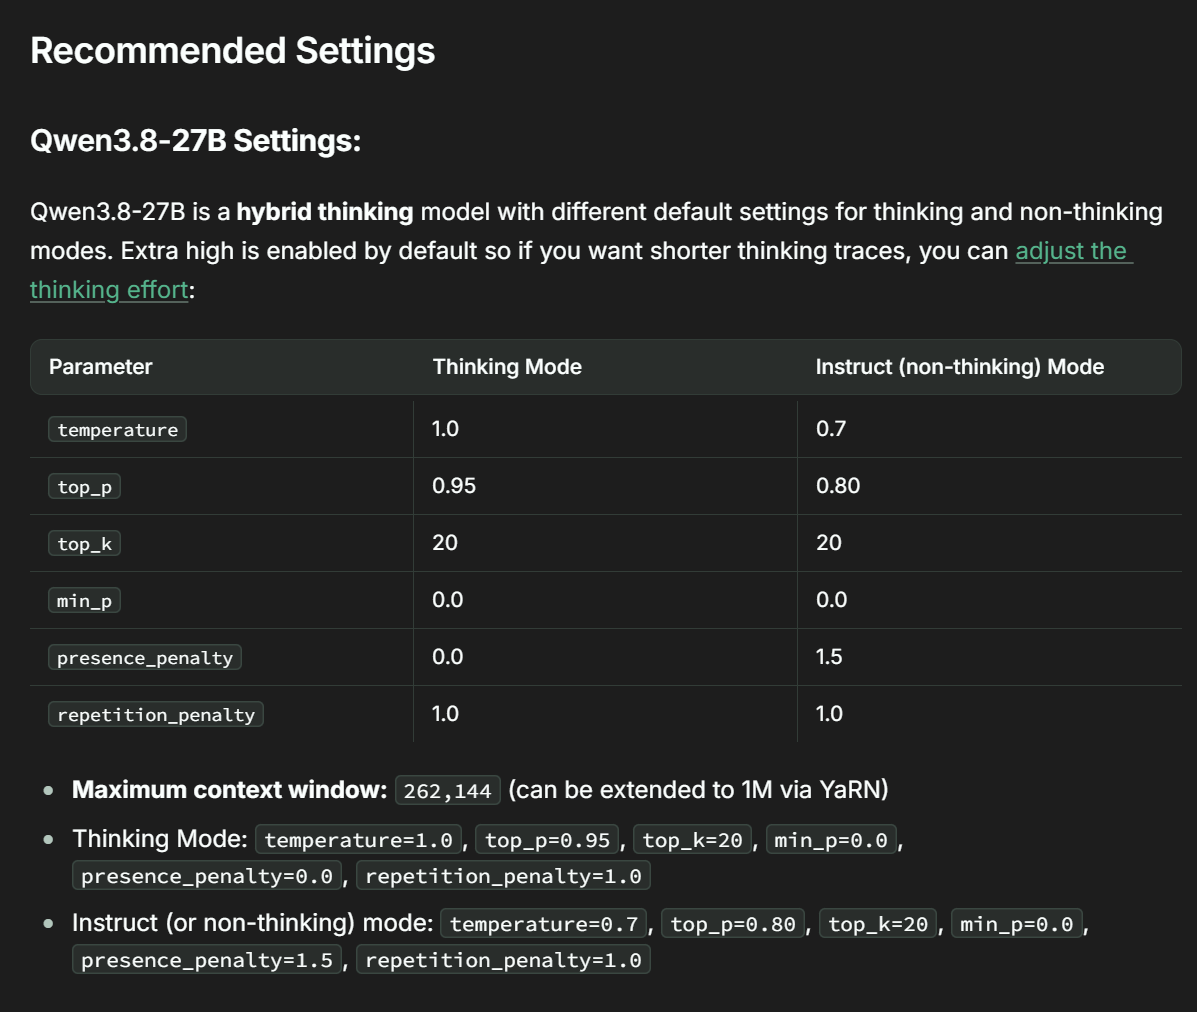
مع إعدادات Unsloth الموصى بها، واجهنا نفس المشكلات الموثقة أعلاه: التكرار في التفكير، رغم منحه أكبر نافذة سياق بحجم 70 ألف توكن مع تقليص الوسط إذا تجاوز السياق هذا الحد.
تجربة تكميم 4 بت
جرّبنا تشغيل تكميم 4 بت وتفريغ باقي حجم النموذج إلى ذاكرة النظام (RAM) وتنفيذ الحساب على أنوية المعالج، وكما كان متوقعًا، انخفضت السرعة إلى 2 توكن/ثانية. كان ذلك بطيئًا جدًا، لكن الدقة كانت أفضل بشكل ملحوظ من 1 بت.
الخلاصة
كان الاستدلال متكررًا وزائدًا عن الحاجة في المسائل الصغيرة والمتوسطة.
استهلك ذلك التفكير المتكرر نافذة السياق بالكامل بسرعة، وهي كانت محدودة أصلًا.
كانت سرعة التوليد على حاسوب محمول بكرت RTX 4060 بذاكرة 8 غيغابايت وذاكرة نظام 16 غيغابايت ثابتة عند حوالي 20 توكن/ثانية.
رغم أن تفريغ كرت الرسوميات كان مضبوطًا على 64/64 (أي إبقاء جميع الطبقات على كرت الرسوميات لتعظيم معدل التوكنات)، إلا أن الذاكرة المؤقتة وأعباء الخادم المحلي كانت لا تزال تشغل عدة غيغابايت من ذاكرة النظام. وقد تسبب ذلك في بطء شديد في تطبيقات أخرى مثل VS Code.
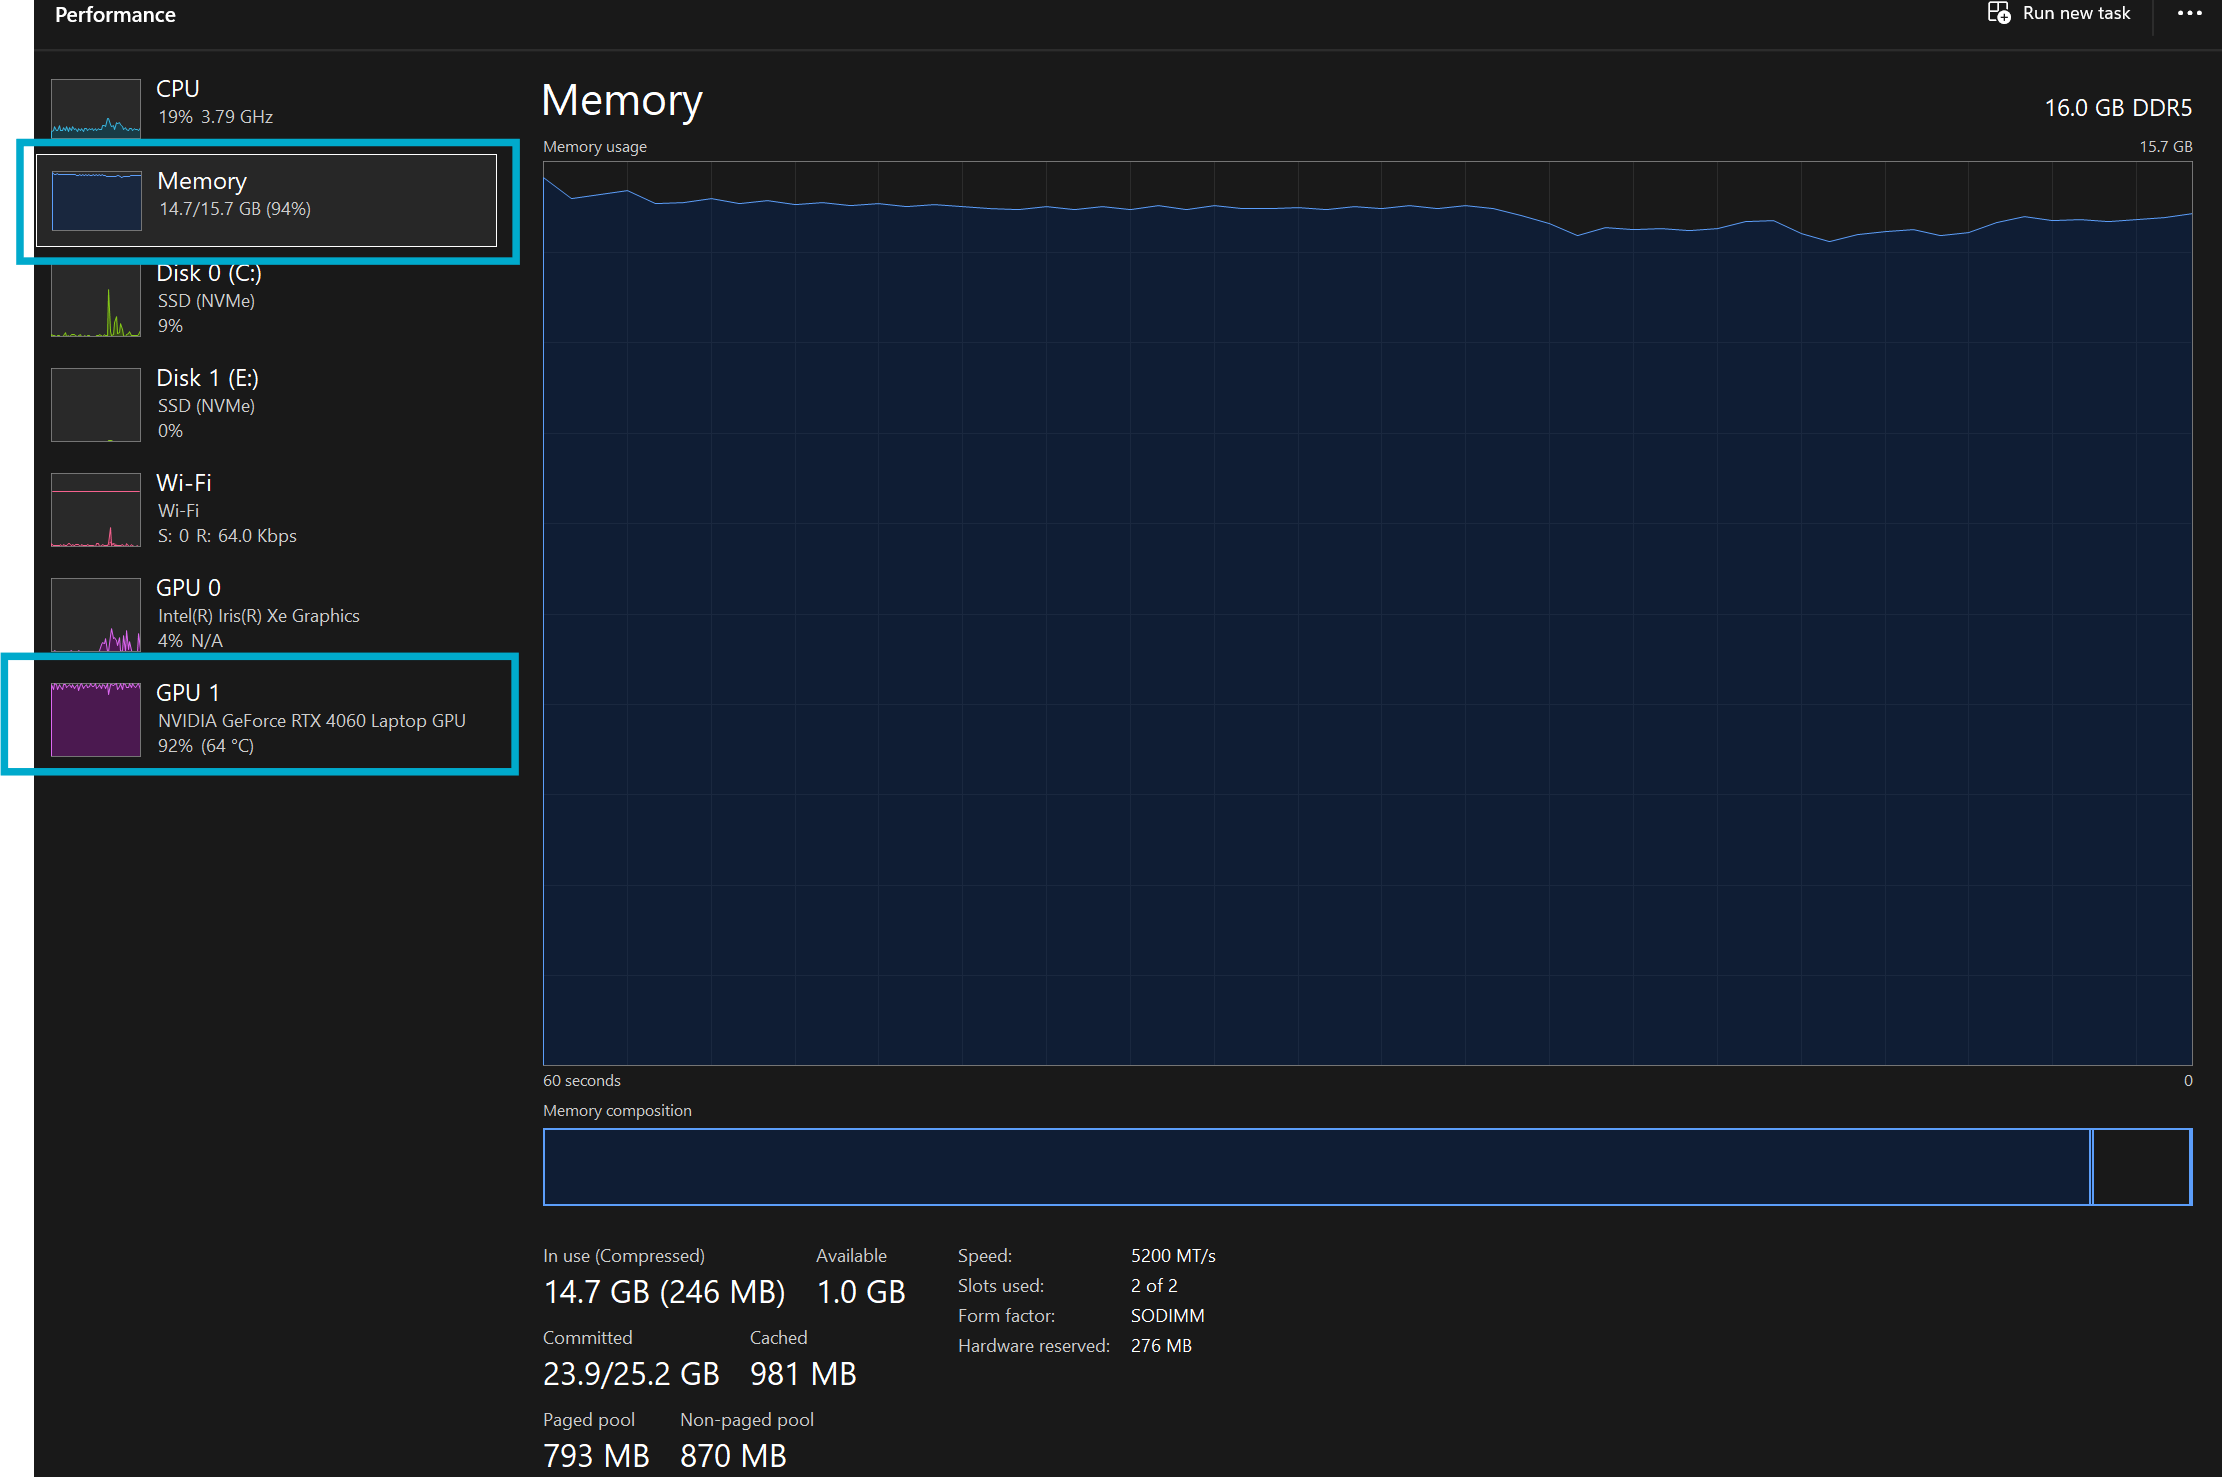
يبدو أن النماذج السحابية ذات الطبقة المجانية المحدودة تتفوق حاليًا بسهولة على النماذج المحلية ذات التكميم المتطرف على الحواسيب المحمولة المتوسطة في مسائل البرمجة أو الاستخدام العام؛ ومع ذلك، يمكن استخدام النموذج المحلي لتصنيف النصوص القصيرة تلقائيًا وبسرعة. ما أعنيه أن الأمر يعتمد على إبداع المطورين في كيفية استغلالهم لهذه النماذج الصغيرة. كما قد يكون هناك أمل في تكميم 4 بت مع ذاكرة موحدة أكبر أو ذاكرة رسوميات أكبر.
